关于 Transformer
这个“变压器”算是老朋友了,但我一直没有系统地认识过它。昨天在 B 站看了别人的介绍,有了些认识,又和 GPT 讨论了一下,想做些记录。
我并不是想在这里剖析 Transformer 的内部结构来学习,以我目前的能力,也未必解释得清楚。我感觉更重要的是先对它有一个宏观的把握和理解,方便后续定位细节。
Transformer 本身
我还是以 GPT 这种大语言模型来理解 Transformer,但 Transformer 本质上是一种更抽象的结构。这种结构放到 GPT 上,就对应了具体的对话任务:已有 token → 预测下一个 token。GPT 本质上是建立在 Transformer 上的概率序列预测模型。
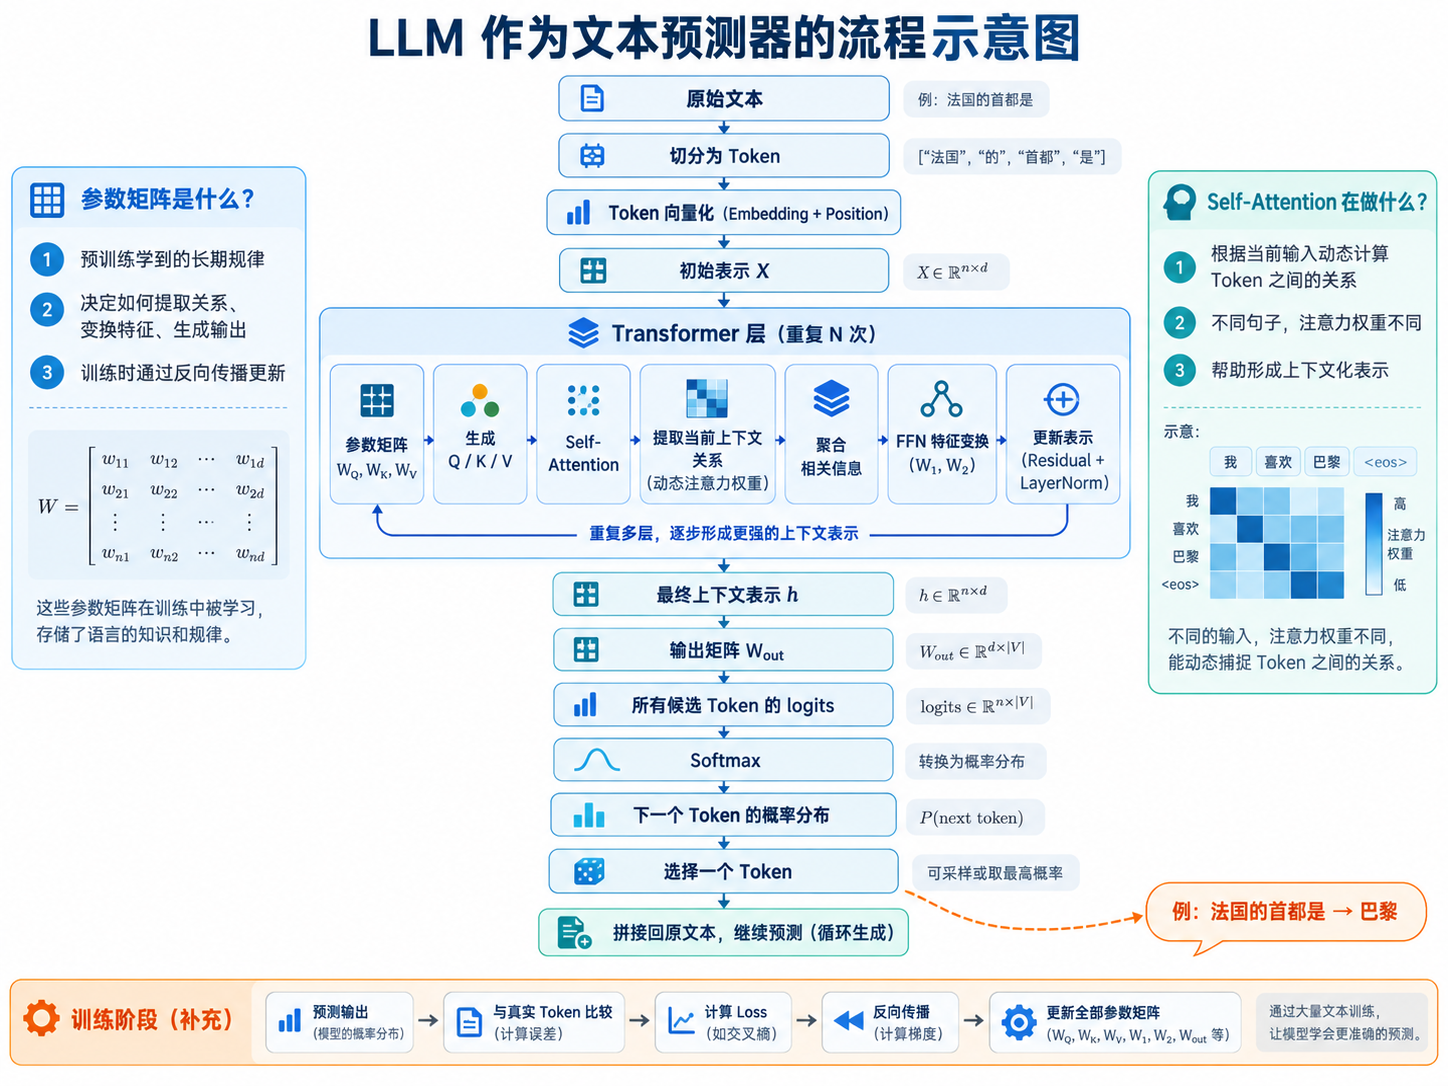
文本先被映射为高维向量。预训练通过海量文本,学习出 Transformer 中的大量参数矩阵。这些参数定义了一个高维非线性函数。面对具体输入时,Self-Attention 会动态计算不同 token 之间的关系,并不断更新它们的上下文表示。最终,模型将当前位置的隐藏表示映射为词表中所有 token 的分数,再通过 softmax 得到下一个 token 的概率分布。
这算是一个更学术的小总结,但我想用一种更启发式的方式去理解。
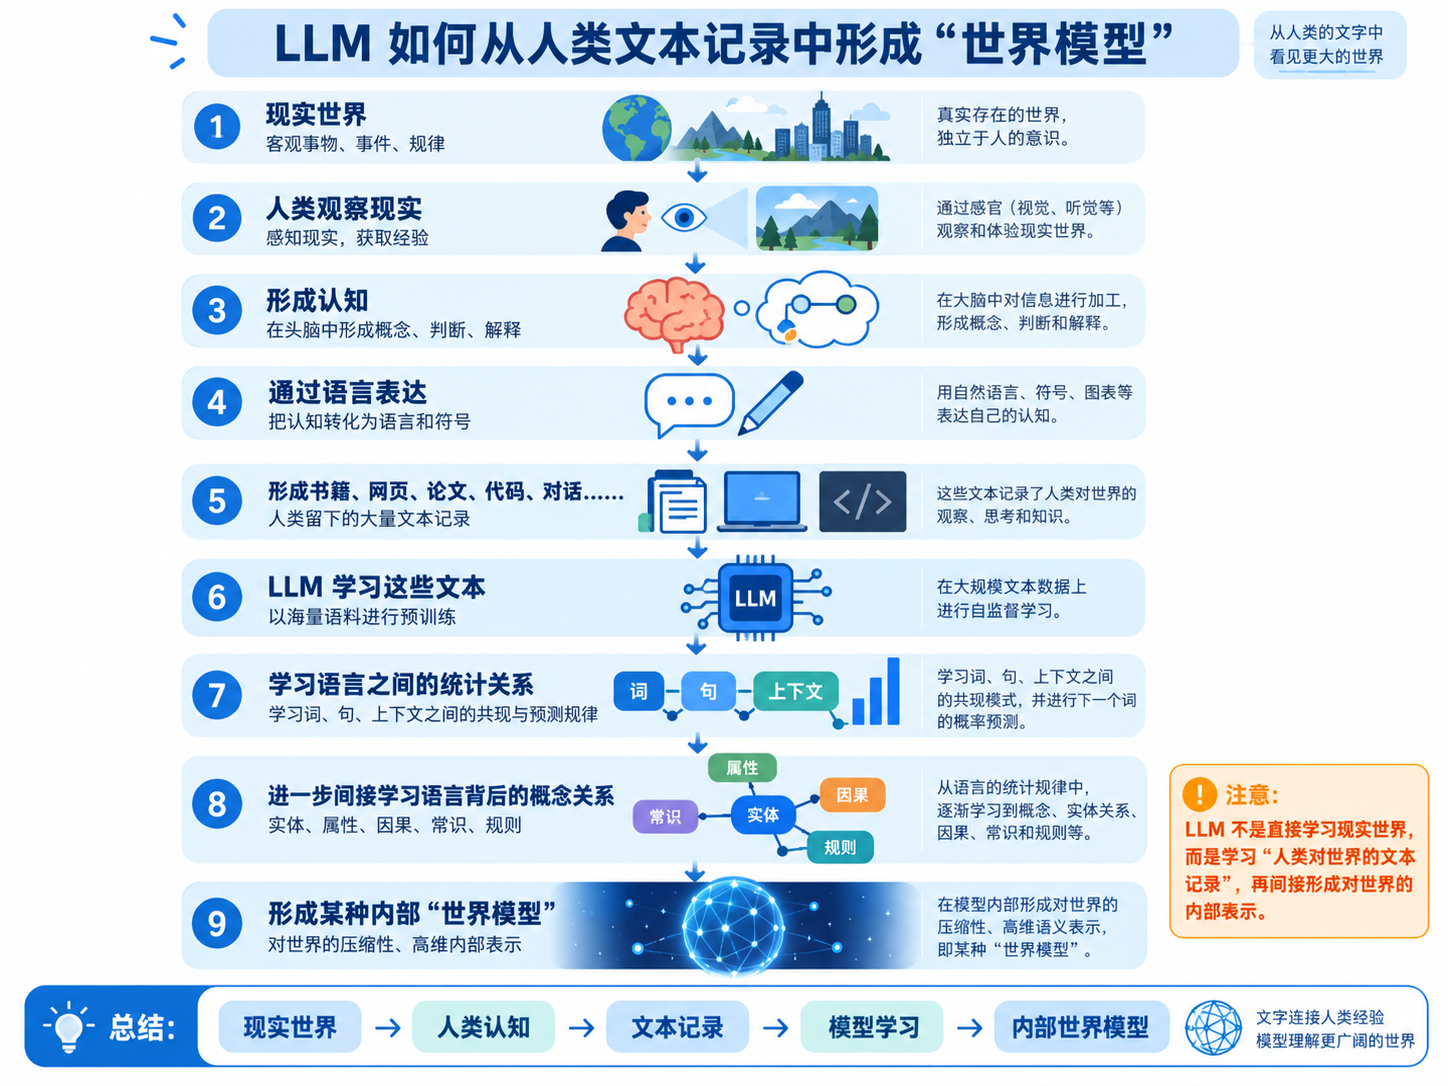
从宏观视角来看,模型训练通过海量预测错误,不断反向传播,把整套矩阵参数调整到一个能很好地预测人类文本的位置。LLM 并不是直接学习世界,而是学习“人类关于世界留下的记录”,但语言预测任务迫使模型压缩出一个关于世界结构的内部表示,也就是一种以文本描述为基础绘制的世界模型。
对于这种“世界模型”,我倾向于把它和 Transformer 的参数矩阵相对应。参数矩阵对应着高维向量空间:我们把文本向量化,让参数化变换不断“理解”,让自注意力机制分析和“定位”。这种理解与定位的不断累积,让文本最终在向量空间里得到正确的状态演化,对应着在世界模型里正确的理解。
GPT 的学术化总结:
LLM 的预训练过程,是利用人类文本不断调整参数,从而构造一个关于人类所记录世界的高维参数化模型;推理时,输入文本被转化为高维表示,并在多层 Transformer 中通过 Attention 的关系定位和参数化变换不断更新自身状态,形成一条表示演化轨迹。所谓模型对当前文本的“理解”,可以抽象为这条轨迹最终逐层演化到一个能够正确表达当前上下文、并对后续 token 做出准确预测的内部状态。
神经网络里的 Transformer
对于神经网络的通用抽象结构,我是这样理解的:量化基本单元,量化基本单元之间的联系,把“基本单元 + 联系”作为输入,设计映射函数得到输出;再把输出和结果比较得到 loss,通过 loss 反向传播调整映射,得到合适的映射,也就是模型。
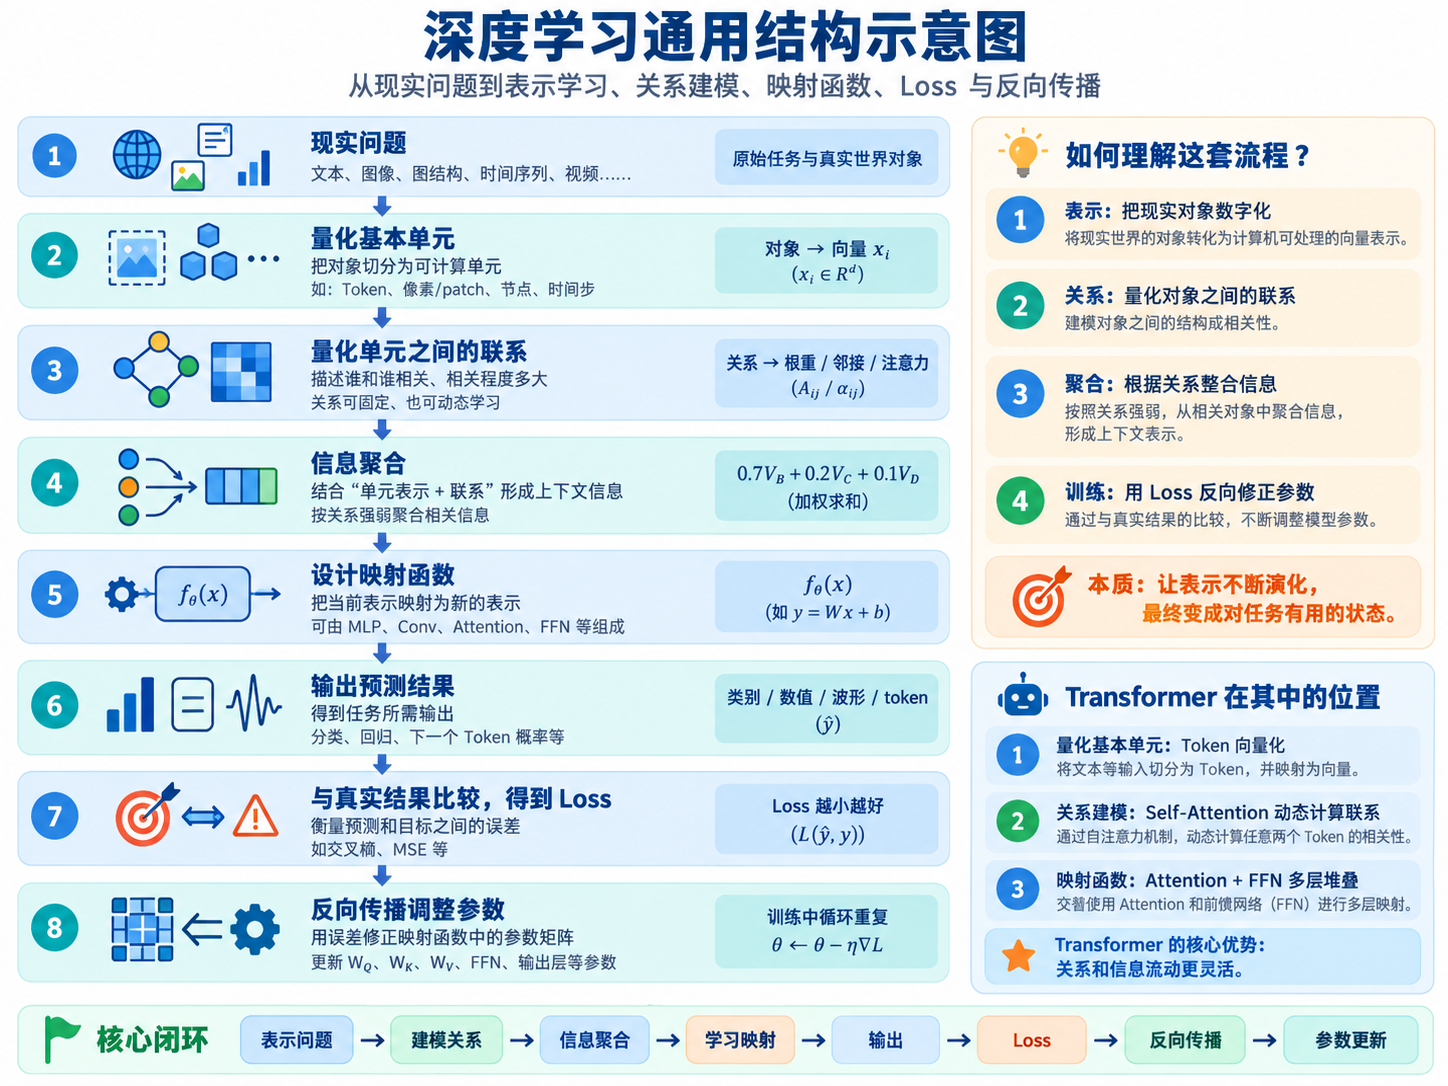
那么,Transformer 在这套框架里的特色是什么呢?比如,CNN 中一个像素主要和附近像素交互;RNN 的当前时间步主要接收前一个时间步的信息;GNN 的节点主要和图中已有边连接的邻居交互。而 Transformer 仿佛会说:“当前这个 token 到底该关注谁,我先不完全写死,让模型根据当前输入自己算。”
提到 Transformer 时,我们经常会提到 Self-Attention,因为 Transformer 最大的特色就在这里。Self-Attention 实际上同时做两件事:先判断谁重要,再按重要程度把信息拿过来。也就是关系建模 + 信息聚合。
Transformer 的核心角色可以总结为:它是一种高度通用的动态关系建模和信息路由架构。